カテゴリー · 95 本 · 最新 2026/11/11 · ページ 4
ベンチマーク
ベンチマーク·H3 Max Relight・Turbo Extend・Pixelcutを実動画で検証fal.aiでH3 Max Relight、Turbo Extend、Pixelcut Looping Videoを検証。照明変更や動画の続きを生成した結果と、公式のUSD料金を紹介します。ベンチマーク·Krea 3を実機検証:画像生成10件・編集8件の結果Krea 3をfal.ai経由で検証。画像生成10件と編集8件の評価、所要時間、API料金を紹介します。ポーランド語の価格表記では誤りが繰り返し見られました。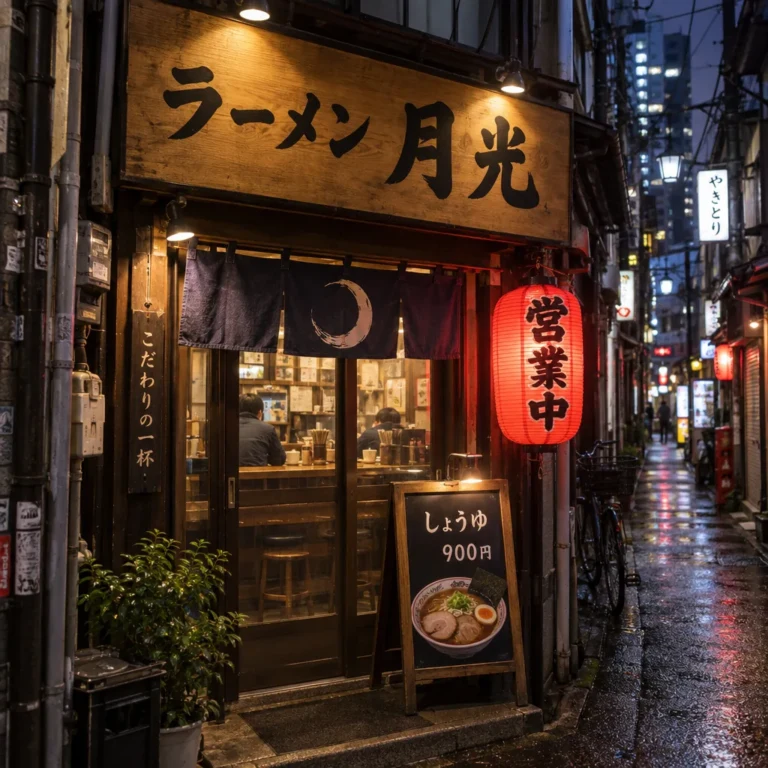 ベンチマーク·日本語の文字を描ける画像生成AIは?21モデルを比較路地のラーメン店と京都の夏祭りポスターを題材に、日本語の文字を比較した。写真らしさが高くても、店名や日時が間違っていれば実用には使いにくい。ベンチマーク·MOSS Imageをレビュー:画像内テキストの精度とポーランド語テストOpenMOSSの画像生成モデルMOSS Imageを検証。ポーランド語の指示文10件で8.5点を記録し、中国語ネオンの文字も高精度でした。ベンチマーク·AIの信頼度0.9とは?basal miniで見る校正とECEAIの信頼度0.9は正答率90%を意味するのでしょうか。3モデル・計50件の実測結果をもとに、校正、ECE、自動化のしきい値の確かめ方を解説します。ベンチマーク·自律型EDRのAI防御エージェントをどう評価する?商用EDR自体も自律的に動く環境で、防御エージェントの効果をどう測るのか。arXiv論文が示す評価上の課題を紹介します。ベンチマーク·Relational Transformerの学習を305秒で達成、単一GPUのベンチマーク単一のNVIDIA H200で品質目標に305.63秒で到達した学習レシピを紹介。研究者らはRelational Transformer向けのタイムアタック型ベンチマークを提案しています。ベンチマーク·リップシンクAI比較:Seedance 2.5、Wan 3.0、InfiniteTalkをテストポーランド語の楽曲を使ってSeedance 2.5、Wan 3.0、InfiniteTalkを比較。同期スコア、生成時間、費用と音声の問題を検証しました。ベンチマーク·FairStress:AI2のベンチマークが明らかにしたLLMの判断の偏りAI2のFairStressは、説得を受けたときにLLMが判断をどれほど維持するかを検証。15モデルで見つかった非対称性と、その限界を紹介します。ベンチマーク·SQLに強いAIは?ChatGPT、Gemini、Claude Codeを比較SQLiteのテストではGPT-6.1 Solが3つのSQLクエリすべてで正解。無料で使う場合や、Claude Codeを選ぶ場合の注意点も紹介します。