Gemini Omni 1.2とSeedance、Kling、Veo、Wanを比較:動画生成AI 6モデル検証
Gemini Omni 1.2 Flash、Veo 3.1、Seedance 2.0、Wan 3.0、Kling 3.0を同一プロンプトで徹底比較。カメラワークと音声精度のテスト結果をまとめました。
👁 111閲覧数
6つの動画生成AIモデルに、句読点まで全く同じ2つのプロンプトを与えて比較しました。1つ目のシーンは、市場でリンゴを売る女性の周囲をカメラが360度フル回転する映像。2つ目のシーンは、庭のバーベキューで2人の男性がどちらのディスカウント店のソーセージにするかで言い争う会話シーンです。テストはGemini Omni 1.2 Flashがリリースされた2026年11月5日の夕方に実施し、クリップはいずれも6秒、解像度720p、音声付きで生成しました。
比較対象は、Omni 1.2、前世代のOmni 1.1、GoogleのVeo 3.1 Lite、ByteDanceのSeedance 2.0 Fast、AlibabaのWan 3.0、そしてKling 3.0 Standardの6種類です。すべてOpenRouterの同一API経由で呼び出し、生成にかかったコストと待ち時間を公平に比較できるように揃えています。なお、Kling 4.0やSeedance 2.5は対象APIで未提供であるか数倍の料金になるため、今回の比較からは除外しています(詳細は後述します)。
比較結果の一覧
| モデル | 6秒のコスト | 生成待ち時間 | カメラの回転 | セリフ音声(ポーランド語検証) |
|---|---|---|---|---|
| Gemini Omni 1.2 Flash | 0.42 USD | 48-49秒 | 完全なワンカット回転 | 明瞭、文末の半文が脱落 |
| Gemini Omni 1.1 Flash | 0.61 USD | 45-46秒 | 回転するが滑らかさに欠ける | 全文発話、ただし3カット割りで顔が変化 |
| Veo 3.1 Lite | 0.30 USD | 54-55秒 | 回転なし、カメラ固定 | 全文を正確に発話、ワンカット |
| Seedance 2.0 Fast | 0.55 USD | 88-115秒 | わずかなズームインのみ | 単語の言い間違い、別人物に変化 |
| Wan 3.0 | 0.51 USD | 159-185秒 | 回転なし、カメラ固定 | 全文を正確に発話、ワンカット |
| Kling 3.0 Standard | 0.76 USD | 133-176秒 | 回転せずカット割り | 指示と異なるセリフに改変 |
セリフの精度チェックは耳だけに頼らず、生成された動画ファイルを音声認識モデルWhisper large-v3に通し、プロンプトのテキストと照合して確認しました。
シーン1:露店の周囲をカメラが回転
プロンプト指示(翻訳):リンゴを売る年配の女性の周りを、人物のサイズを保ったままカット割りなしで滑らかにカメラが360度旋回する。この指示はモデルにとって難度が高い課題です。AIは女性の後ろ姿や背後の風景を破綻なく補完し、回転が終わったあとに元の顔へと正確に戻らなければならないためです。
Omni 1.2は指示通りの動きを再現しました。カメラは正面から側面を通り、女性がスカーフを整える後ろ姿を捉えてから、再び笑顔の正面へと戻ります。顔の特徴と花柄のスカーフは、最初と最後で一貫性が保たれています。前世代のOmni 1.1も回転を試み、背後まで回り込みますが、カメラワークにぎこちなさが見られます。
他のモデルは回転の指示を守れませんでした。Veo 3.1 LiteとWan 3.0は三脚に固定したようなアングルになり、女性が手を振るだけのアニメーションになりました。Seedanceはわずかにズームインした程度です。Klingは指示にあった「カット割りなし」を無視し、異なる背景をつなぎ合わせた複数カットの映像を出力しました。
シーン2:庭でのバーベキューの口論
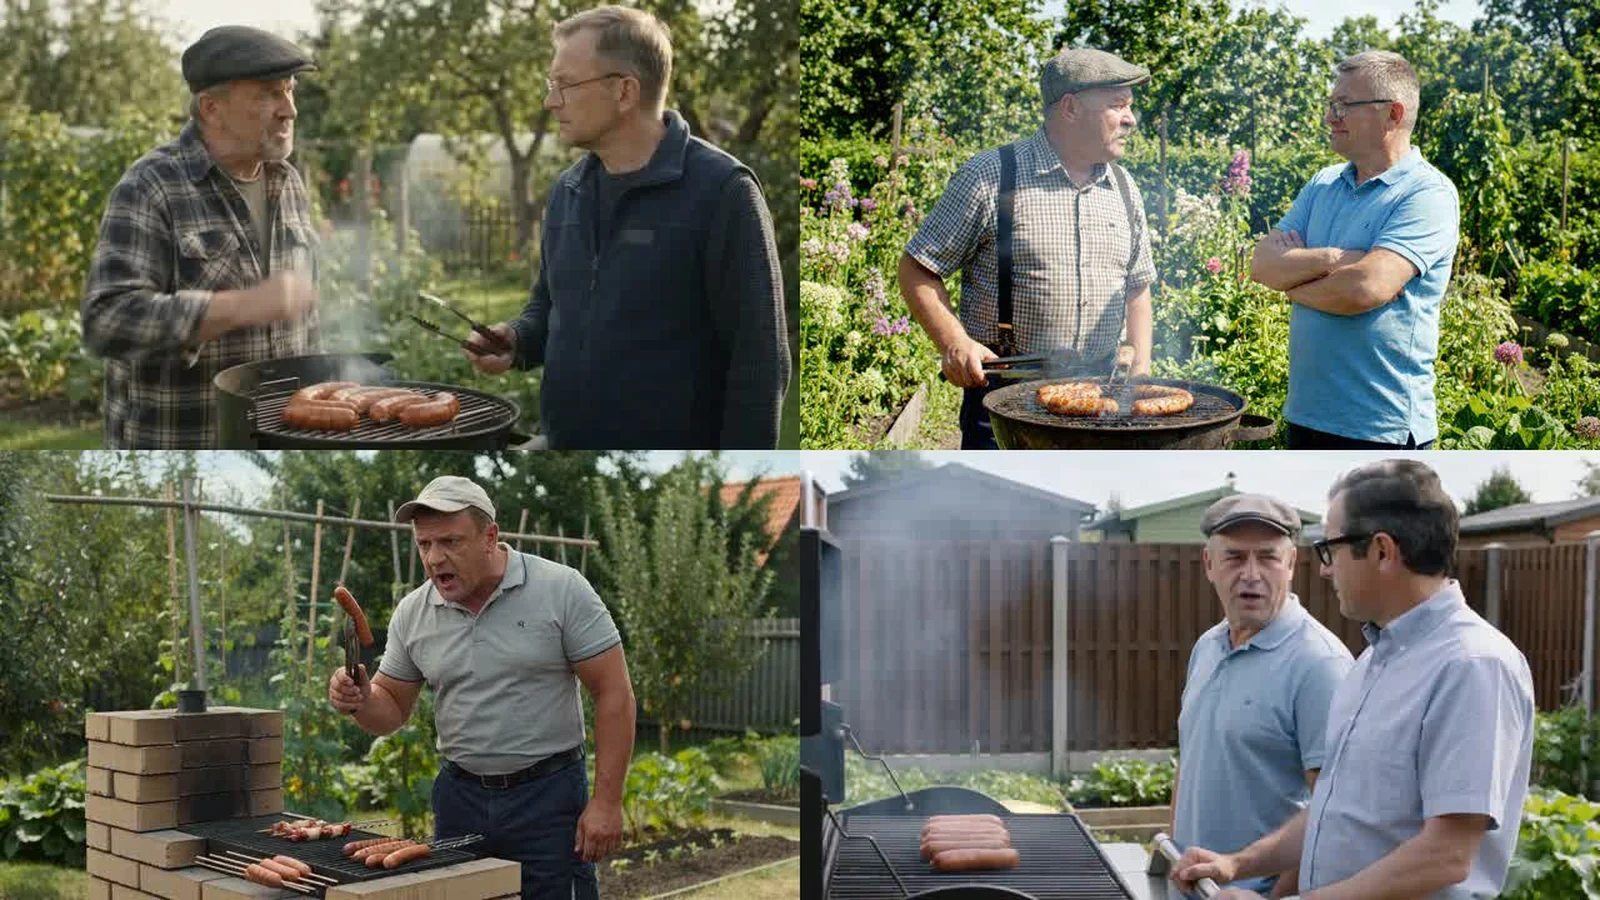
プロンプト指示(翻訳):区画庭園のグリル前にいる50代の男性2人。ハンチング帽をかぶった男性が「ソーセージはLidlじゃなくてBiedronkaで買えって言っただろ!」と言い、メガネをかけたもう1人が「文句言わずに食えよ」と言い返す(実際のプロンプトではポーランド語の会話を指示)。
Omni 1.2は安定したワンカットで生成し、2人の人物像が一貫して維持され、唇の動きと音声の同期も合っていました。ただし、最初のセリフの後半が抜け落ち、「Biedronkaで買え」のみになり「Lidlじゃなくて」が言えていません。6秒という短い尺に2つのセリフを収めるのが厳しく、早口にする代わりにテキストを削った形です。なお、参照画像を入力として与えた別のテストでは、全文を発話できました。
Omni 1.1はセリフをすべて発話したものの、3つのカットに分割され、中央のカットでは緑のTシャツを着た全く別の人物が座る形になってしまいました。このシーンで最も優秀だったのはVeo 3.1 LiteとWan 3.0で、店名の固有名詞を含め全文を明瞭に発話したうえ、ワンカットでまとめました。Seedance 2.0 Fastは2人目の人物をビールを持つ別人に置き換えてしまい、発音も崩れが生じました(「kielbana」「biedynki」「z lita」のように発音)。Klingは最も不自然な挙動を見せ、指示された表現を別の言い回しに変えたうえ、2人目のセリフが意味不明な発音に変わっていました。
どのモデルを選ぶべきか
今回の2つの検証シーンを見る限り、全方位で完璧な万能モデルはまだ存在しません。
- カメラワークと人物の一貫性:Omni 1.2が圧倒的です。カット割りなしで真の360度旋回を実現した唯一のモデルであり、どのシーンでも人物の顔が途中で入れ替わりませんでした。
- 低コストで正確な発話:Veo 3.1 Liteが優れています。1秒あたり0.05 USDという安さでセリフの欠落がなく正確に発音しました。ただしカメラワークは固定で、生成可能な長さも4秒、6秒、8秒に限られます。
- 生成速度:Omni 1.1と1.2が1分未満で完了し高速でした。WanとKlingは生成完了まで約3分近く待たされます。
- 外国語のセリフ指定で注意が必要なモデル:今回の条件では、Kling 3.0 StandardとSeedance 2.0 Fastは発話の崩れや意図しない改変が多く見られました。
補足として、ByteDanceの最上位モデルであるSeedance 2.5は、OpenRouterの720p生成で1秒あたり約0.23 USDとOmni 1.2の3倍以上のコストがかかるため、今回のテストからは外しています。またKling 4.0は公開レートが明示されていない限定的なAPI提供にとどまっています。秒単位の詳細なコスト一覧についてはGemini Omni 1.2の料金解説を、複数シーンによる過去の総合比較は動画生成AIアリーナを参照してください。
発売時の全検証テストはGemini Omni Flashハブにまとめています。
Kiramesuの関連記事