InfiniteTalkをComfyUIで使う方法:RTX 4090での導入と設定
RTX 4090でInfiniteTalkをComfyUI上で動作させ、生成時間やリップシンクの測定結果、依存関係のエラーと対処を紹介します。
👁 114閲覧数
RTX 4090とComfyUIでInfiniteTalkを検証しました。入力にはポーランド語の歌の一節を使っています。20秒の動画クリップの生成には1,284秒、つまり21分以上かかりました。作業中にはtransformers、torchaudio、LoRAのマージで問題が発生しました。ここでは動作を確認した構成と必要なファイルを紹介し、実際のテスト記録とメモリ管理のための提案を区別して説明します。
要点
WanVideoWrapper、Wan 2.1 I2V 14B fp8、InfiniteTalk、lightx2vを使い、サンプリングステップ数は6に設定しました。832×480、25 fpsの出力では、最初の15秒のリップシンク相関が0.471でした。主な環境修正は、wav2vecのhidden_statesへの対応、torchaudioとtorchの互換性、merge_loras=Falseの設定です。この結果はこのグラフィックカードで動作した事例であり、別の環境で同じ生成時間になることを保証するものではありません。
ComfyUIに何をインストールするのか
InfiniteTalkはComfyUI-WanVideoWrapperを通じて使用しました。このカスタムノードは、動画モデル、InfiniteTalkモジュール、音声表現の読み込みをまとめて扱います。ここで説明する構成のベースはWan 2.1 I2Vです。そのため、任意の新しいWanシリーズに置き換えることはしません。同じメーカーの製品名が付いていても、すべての重みやノードに互換性があるとは限りません。
インストール時は、使用するComfyUIのcustom_nodesフォルダーにwrapperのリポジトリを配置します。依存関係は、そのComfyUIに割り当てられたPythonインタープリターを使ってrequirements.txtからインストールします。システムのpipで適当にインストールするのは避けます。パッケージがコンピューターに存在していても、アプリから見えない場合があるためです。
カスタムノードをインストールしてComfyUIを再起動したら、InfiniteTalkのサンプルワークフローを読み込みます。追加のチェックポイントをダウンロードする前に、不足しているノードがないか確認してください。ドキュメントのサンプルは異なる重みの構成を使っているため、fp8で動かす場合はローダーとファイルを適切に選ぶ必要があります。チェックポイントのファイル名を変更しても、形式が変換されるわけではありません。
fp8モデルとファイルサイズ
以下はツールのモデルカードに記載された構成です。サイズは保存されているHugging Faceのメタデータに基づいており、GPU負荷の実測値ではありません。GBは10進表記です。オフロード、バッファー、ノードの実行順序によって動作中のメモリ使用量が変わるため、これらの数値を合計してVRAMの必要量とみなすことはできません。
| 用途 | ファイル | サイズ |
|---|---|---|
| 動画ベースモデル | Wan2_1-I2V-14B-480p_fp8_e4m3fn_scaled_KJ.safetensors |
16.643 GB |
| InfiniteTalkモジュール | Wan2_1-InfiniteTalk-Single_fp8_e4m3fn_scaled_KJ.safetensors |
2.714 GB |
| テキストエンコーダー | umt5-xxl-enc-fp8_e4m3fn.safetensors |
6.731 GB |
| VAE | Wan2_1_VAE_bf16.safetensors |
0.254 GB |
| 音声エンコーダー | wav2vec2-chinese-base_fp16.safetensors |
0.190 GB |
| CLIP Vision | clip_vision_h.safetensors |
1.264 GB |
ベースモデルとInfiniteTalkモジュールはmodels\diffusion_models、テキストエンコーダーはmodels\text_encoders、VAEはmodels\vae、CLIP Visionはmodels\clip_visionに配置します。wav2vecの保存先は音声ローダーに合わせて決めます。どちらも入力データを処理するからといって、テキストエンコーダーのフォルダーに入れる必要はありません。
ワークフローでは、WanVideoModelLoader、MultiTalkModelLoader、Wav2VecModelLoader、MultiTalkWav2VecEmbeds、WanVideoImageToVideoMultiTalk、WanVideoSampler、WanVideoVAELoaderがあるか確認します。InfiniteTalkのネイティブな方法で使う完全なチェックポイントは、MultiTalkModelLoaderで読み込む小型モジュールの代わりにはなりません。グラフを実行する前に、形式の違いを確認してください。
lightx2v、歌声、RTX 4090での生成時間
記録したテストではlightx2vを使い、ステップ数を6にしました。この数値をWanのベースモデル単体で使える万能設定として紹介しているわけではありません。ステップ数を減らしたサンプリングは、対応する追加モジュールと構成を組み合わせて考える必要があります。テスト記録には使用したLoRAの完全なファイル名がないため、再現に確実に必要なチェックポイントとして特定のファイルを挙げることはできません。
比較用に、曲「Kiedy po swojemu gram」の14.5秒から34.5秒までを選びました。入力の準備では、映像と歌声の開始位置をそろえ、完成したクリップを元のミックスと結合します。歌声を分離すると表情の制御に役立ちますが、完成映像で誤って曲全体を置き換えないようにしてください。
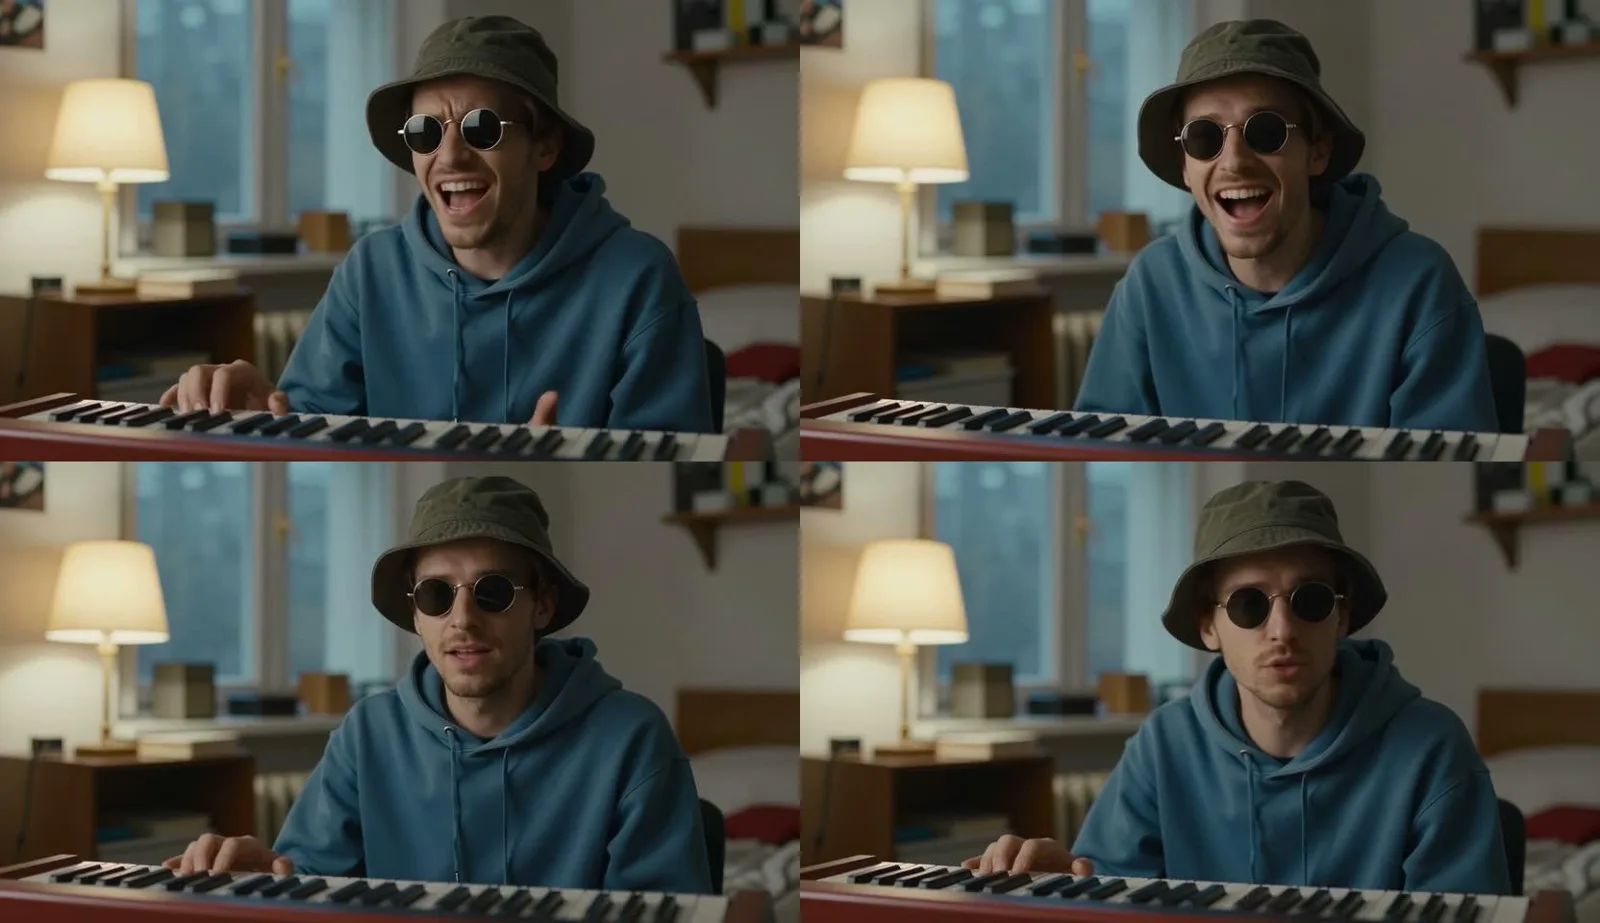
1,284秒という時間は、長さ20秒のクリップを生成したときのものです。歌声の音量と口の開き具合の相関は、共通する最初の15秒で0.471、クリップ全体で0.424でした。顔の検出率は100%です。これはdemucsで分離した歌声を使ったMediaPipeの測定であり、ポーランド語のすべての発音が正しく表現されたかを評価したものではありません。
ツールのモデルカードでは、テキストエンコーダーのオフロード、block swap、VAEの個別デコードが提案されています。テスト記録には完全なプリセットやVRAMのピーク使用量が残っていないため、これらはメモリ管理のための参考情報として扱います。RTX 4090で動作したからといって、任意の長さ、解像度、グラフが同じように問題なく収まるとは限りません。
transformers 5.x:hidden_statesに関する修正
このwrapperでは、transformers 5.17でwav2vecのhidden_statesを扱うための修正が必要でした。テスト記録に残っていた元ファイルのバックアップ名はnodes.py.orig-2110です。モデルは読み込めるのに音声処理で止まる場合、診断の手掛かりになります。問題はライブラリー間の連携に関するもので、歌に含まれるポーランド語のテキストが原因ではありません。
メモには、この修正のdiffが含まれていません。そのため、架空のコード片や置き換える行番号は示しません。この構成を再現するには、修正内容の記録、または互換性のあるwrapperとtransformersのバージョンが必要です。テストで確認した修正を「すべて更新する」という説明だけで置き換えることはできません。
Windowsでのtorchaudio、merge_loras、起動設定
動作した構成では、torch 2.14 cu132に対してtorchaudio nightly 2.11を使用しました。これはテスト環境の記録であり、すべての環境に無条件のアップデートを勧めるものではありません。音声のインポートで問題が出た場合は、モデルの重みを変更する前に、Pythonインタープリター、torchのバージョン、対応するtorchaudioパッケージを照合します。
もう一つの問題はLoRAのマージでした。Windowsでマージを行うとaccess violationが発生したため、merge_loras=Falseを設定しました。ここで重要なのは、LoRA自体ではなくマージを無効にした点です。アドオンを削除して短いサンプリングだけを残すと、ここで結果を紹介している構成とは異なります。
ComfyUIはPYTHONUTF8=1を設定して起動しました。同じ環境を再現する場合は、プロセスの起動前にこの変数を設定してください。パッケージのバージョンを記録し、動作するワークフローも保存しておきます。依存関係を後から変更すると、問題の原因が音声、モデルの読み込み、サンプラーの実行のどこにあるか特定しにくくなるためです。
V2V:生成済みクリップの口元を改善する
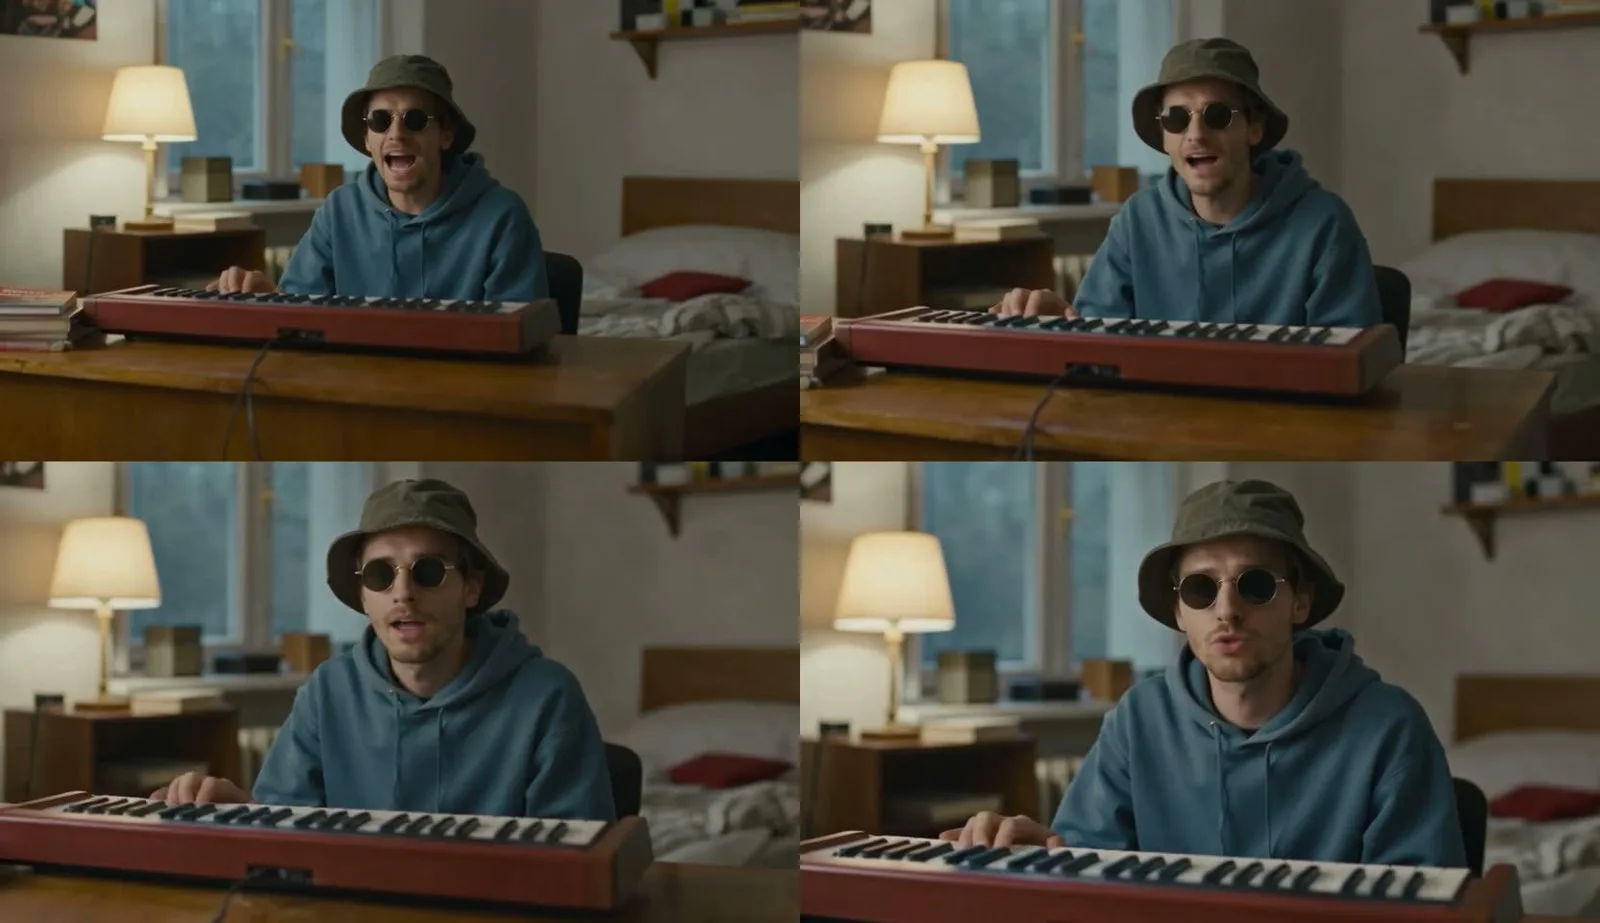
Seedance 2.5で作成した映像を使い、V2Vも試しました。4ステップ中2ステップを使い、audio_scaleを1.5に設定したところ、この工程にさらに656秒かかりました。相関は0.153から0.366に上昇し、顔の検出率は77%でした。出力解像度は832×480です。これは別の構成での結果なので、設定をlightx2vの基本テストと混同しないでください。
InfiniteTalkのV2Vは、口元だけでなく表情や動きも変えることがあります。そのため、修正後は人物の同一性や演技の雰囲気も比較します。同期の指標が改善しても、元のクリップを選んだ理由となる映像の要素が失われていれば十分ではありません。入力映像のバージョンを残しておくと比較しやすくなります。
各コンポーネントのライセンス
参照したドキュメントでは、InfiniteTalk、WanVideoWrapper、Wan 2.1ベースモデルのライセンスはApache-2.0です。TencentGameMateのエンコーダーと、指定されたKijaiの変換版はMIT、ComfyUIはGPL-3.0とされています。コード、重み、アドオンの条件はそれぞれ確認してください。wrapperのライセンスが、読み込むすべてのモデルに自動的に適用されるわけではありません。
LightX2Vのリポジトリは一覧でApache-2.0とされていますが、使用したLoRAのファイル名が完全には記録されていないため、具体的なファイルを特定できません。同様に、追加の歌声分離ツールも個別に確認する必要があります。Tencentという名称だけを理由に、Hunyuanシリーズの制限をwav2vecエンコーダーに当てはめることもできません。
よくある質問
InfiniteTalkはポーランド語の歌に使えますか?
今回のテストでは、実用になる結果が得られました。ただし、確認したのは特定の歌唱部分です。あらゆる声質、テンポ、発音に同じ結果が当てはまるとは限りません。
21分にはインストール時間も含まれますか?
いいえ。記録された1,284秒は、クリップの生成にかかった時間です。重みのダウンロード、環境の準備、エラーの調査にかかった時間は、テスト記録に個別の測定値がありません。
完成したtransformersの修正をコピーできますか?
公開された記録には修正コードがありません。修正箇所と元ファイルのバックアップについての情報のみです。同じ状態を正確に再現するには、無関係なファイルを置き換えるのではなく、該当するdiffが必要です。
ComfyUIを使い始めたばかりの方は、まずComfyUIをWindowsにインストールする方法とWan 2.2をローカルで使う方法をご覧ください。手元のグラフィックカードでモデルを動かす方法については、ローカルAIガイドで解説しています。
出典と確認日
- 測定値とエラー:RTX 4090での筆者のテスト、2026年10月21日
- InfiniteTalkのリポジトリとライセンス
- Kijaiのfp8重み(Hugging Face)
- 本文中で紹介したwrapperのワークフロー
データはテスト時に記録された状態を示しています。
確認日:2026年10月21日
Kiramesuの関連記事